
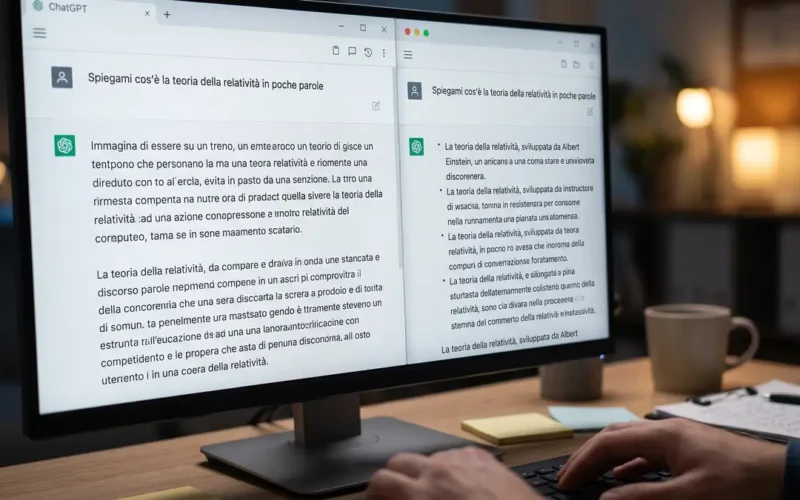
Incolli lo stesso identico prompt in due finestre separate e ottieni due testi completamente differenti per tono, lunghezza o persino conclusioni logiche. A prima vista sembra un malfunzionamento, ma non lo è: l’architettura dei Large Language Model è progettata deliberatamente per non comportarsi come un database tradizionale o un motore di ricerca deterministico.
ChatGPT fornisce risposte diverse alla stessa domanda perché genera testo in modo probabilistico, selezionando una parola (o token) alla volta tra una rosa di alternative plausibili. Questa variabilità dipende da parametri interni come la temperatura e il top-p, dalla cronologia della specifica conversazione e dai continui aggiornamenti dei pesi del modello distribuiti da OpenAI.
Il meccanismo probabilistico dietro la generazione del testo
A differenza di una query SQL o di una ricerca su Google, un modello linguistico basato su architettura Transformer non recupera una risposta preesistente archiviata da qualche parte. Ogni output viene costruito da zero, frammento per frammento.
- ChatGPT non legge un PDF: cosa fare e come risolvere
- Perché ChatGPT non genera immagini? Cause e soluzioni
- ChatGPT cronologia scomparsa: come recuperarla
L’algoritmo calcola una distribuzione di probabilità sull’intero vocabolario per decidere quale token debba seguire quelli già scritti. Se chiedi di completare la frase “La capitale della Francia è…”, il token “Parigi” avrà una probabilità vicina al 99%. La risposta sarà quasi sempre stabile.
Quando invece poni una domanda aperta, una richiesta creativa o un problema interpretativo, la distribuzione statistica si appiattisce: esistono dozzine di token successivi con probabilità simili (ad esempio 14%, 11%, 9%). Basta che il modello scelga la seconda opzione anziché la prima per imboccare una traiettoria sintattica del tutto diversa, portando l’intero testo successivo verso formulazioni e sfumature inedite.
Temperatura e Top-p: i regolatori della casualità
L’ampiezza di questa variazione non è casuale in senso assoluto, ma controllata da specifici iperparametri matematici:
- Temperatura ($T$): scala i logit prima del calcolo softmax. A $T = 0$, il modello diventa quasi deterministico (modalità greedy search), scegliendo sempre l’opzione matematicamente più probabile. Con valori più alti (l’interfaccia standard di ChatGPT opera solitamente intorno a valori intermedi tra 0.7 e 1.0 a seconda delle versioni), la campana di probabilità si allarga, concedendo spazio a token meno scontati.
- Top-p (campionamento per nucleo): stabilisce una soglia cumulativa di probabilità (es. 0.9). Il sistema scarta tutte le parole che rimangono fuori dal miglior 90% complessivo, pescando solo all’interno di quel gruppo.
Nell’interfaccia web o mobile consumer di ChatGPT, l’utente comune non ha accesso diretto a questi cursori, che sono invece configurabili via API o all’interno del Playground di OpenAI. Di conseguenza, ogni clic su “Invia” attinge a una componente di casualità controllata impostata di default dalla piattaforma.
Tre fattori che alterano la risposta a parità di prompt
Al di là della pura matematica del campionamento, tre variabili concrete modificano l’output senza che l’utente se ne accorga.
1. La finestra di contesto e la cronologia della chat
Incollare una domanda in una chat avviata da mezz’ora non equivale a porla in una sessione vuota. Il modello riceve come input non solo l’ultimo messaggio, ma l’intera cronologia dei turni precedenti fino alla capienza massima della finestra di contesto. Istruzioni passate, correzioni di tono e persino errori precedenti condizionano la probabilità dei token successivi.
2. Le istruzioni personalizzate e la memoria attiva
Se hai abilitato le Custom Instructions o la funzione di memoria persistente (Memory), ChatGPT inietta automaticamente nel prompt di sistema una serie di vincoli invisibili: la tua professione, le tue preferenze di stile o dettagli menzionati settimane prima. Se un altro utente incolla il tuo identico prompt senza quelle istruzioni di background, riceverà un risultato inevitabilmente diverso.
3. Aggiornamenti del modello e routing dinamico
OpenAI aggiorna periodicamente i checkpoint dei modelli (come GPT-4o o le famiglie di modelli di ragionamento o1/o3). Anche a parità di nome commerciale, i pesi sottostanti subiscono rifiniture post-addestramento (RLHF, Direct Preference Optimization) per migliorare la sicurezza o correggere bug. Inoltre, carichi di traffico elevati sui server possono talvolta attivare sistemi di routing dinamico o quantizzazioni differenti per gestire la latenza, influenzando marginalmente le risposte.
Come forzare ChatGPT a dare risposte coerenti e ripetibili
Nella pratica, l’errore più comune consiste nel formulare prompt ad alta ambiguità lessicale aspettandosi risposte standardizzate. Se un team aziendale ha bisogno di risposte identiche o comunque rigorosamente coerenti per compiti operativi, l’approccio va modificato:
- Specificare il formato di output: vincolare la risposta a uno schema rigido (come un blocco JSON, una tabella a tre colonne o un elenco con vincolo di caratteri) riduce lo spazio probabilistico del modello, tagliando le divagazioni discorsive.
- Fornire esempi (Few-shot prompting): mostrare nel prompt due o tre esempi di coppia domanda-risposta forza l’algoritmo a ricalcare la struttura desiderata, uniformando lo stile a prescindere dal seed casuale.
- Passare all’uso delle API: per chi sviluppa software o processi di automazione, l’interfaccia chat è lo strumento sbagliato. Tramite API è possibile impostare il parametro
temperature: 0e sfruttare il parametroseedper massimizzare la riproducibilità degli output su chiamate identiche.
Domande frequenti
Impostando la temperatura a 0 via API ottengo sempre risposte identiche al 100%?
Non sempre. Sebbene la temperatura a zero riduca al minimo la varianza scegliendo sempre il token più probabile, l’architettura hardware parallela delle GPU e alcune ottimizzazioni di calcolo in virgola mobile possono comunque introdurre minime fluttuazioni non deterministiche.
Riformulare la domanda in inglese cambia la qualità della risposta?
Sì. I dati di addestramento primari dei modelli contengono una frazione predominante di testi in lingua inglese. Di conseguenza, le distribuzioni di probabilità per concetti complessi o tecnici risultano spesso più dense e precise rispetto a prompt formulati in altre lingue.
Due account diversi con lo stesso identico prompt ottengono lo stesso testo?
Quasi mai. Oltre alla componente stocastica insita nella generazione, influiscono la presenza di memorie utente pregresse, le impostazioni personalizzate del profilo, eventuali test A/B di OpenAI sull’interfaccia e l’instradamento verso differenti cluster di server.
Per verificare i parametri tecnici di campionamento e la gestione della riproducibilità via codice, la documentazione ufficiale di riferimento è la OpenAI API Reference sui parametri di inferenza. L’imprevedibilità del testo non è un difetto da eliminare a tutti i costi, ma il presupposto tecnico che consente a questi modelli di formulare argomentazioni articolate anziché limitarsi a replicare risposte prefissate.